전체 글 60

[huggingface] 학습 VS 추론

https://blog.naver.com/ksh368/223411421968 AI 학습 vs 추론인공지능(AI)의 두 핵심 기능인 학습과 추론은 AI 시스템의 지능을 구현하는 데 중요한 역할을 합니다....blog.naver.com - 학습(Training)은 모델의 파라미터를 바꾸는 과정이고, 추론(Inference)은 학습이 끝난 모델의 파라미터를 그대로 사용해서 결과를 만드는 과정입니다. 구분 학습(Training)추론(Inference)목적모델이 패턴을 배우게 함학습한 내용을 이용해 답을 생성입력대량의 학습 데이터사용자의 질문/프롬프트가중치 변경OX역전파OXOptimizer사용사용하지 않음계산량매우 큼상대적으로 작음예시GPT 모델을 학습/파인튜닝ChatGPT에게 질문하기 학습 (Trainin..
LLM 2026.10.07

[DataEngineering] ETL, ELT

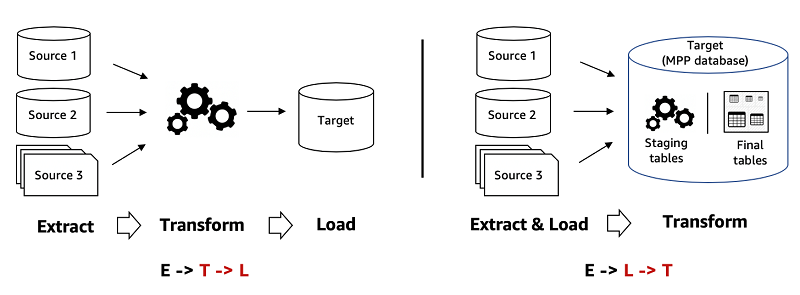
https://aws.amazon.com/ko/compare/the-difference-between-etl-and-elt/ ETL과 ELT - 데이터 처리 접근 방식 간의 차이점 - AWSETL과 ELT의 차이점은 무엇인가요? AWS에서 ETL 및 ELT를 사용하는 방법.aws.amazon.com ETL(Extrack Transform Load), 추출 가공 저장 1. 다양한 소스에서 원시 데이터 추출 2. 보조 처리 서버를 사용하여 해당 데이터를 전환(가공)3. 해당 데이터를 대상 데이터베이스에 적재(저장) EX) 애플리케이션 로그 ↓Logstash input ↓grok / mutate / date / 개인정보 마스킹 ↓Elasticsearch 저장 ELT(xtrack Load Tra..

DataEngineering 2026.09.30

[Spring-AI] RAG(Retrieval Augmented Generation)

https://www.elastic.co/kr/what-is/retrieval-augmented-generation 검색 증강 생성(RAG)이란? | 포괄적인 RAG 안내서기술 및 애플리케이션에서의 검색 증강 생성과 그 사용 사례를 정의합니다. 검색 증강 생성의 이점, 문제점 및 미래 동향을 이해합니다.www.elastic.co RAG (Retrieval Augmented Generation, 검색 증강 생성)- 검색 증강 생성(RAG)은 프라이빈 또는 독점 데이터 소스의 정보로 텍스트 생성을 보완하는 기술입니다.- 검색 증강 생성은 추가 데이터 소스의 컨텍스트를 더하고 훈련을 통해 LLM의 원래 지식 기반을 보완함으로써 검색 경험의 정확도를 개선할 수 있습니다. (Prompt Stuffing, 벡터 디..

LLM 2026.09.28

[Spring-AI] 벡터 임베딩(Vector Embedding)

https://www.elastic.co/kr/what-is/vector-embedding 벡터 임베딩이란 무엇인가? | 벡터 임베딩 종합 안내서벡터 임베딩을 정의하고 자연어 처리 및 머신 러닝의 사용 사례를 이해합니다. 벡터 임베딩 유형과 생성 방법을 살펴보세요.www.elastic.cohttps://www.bobdc.com/blog/semantic-web-semantics-vs-vect/ Semantic web semantics vs. vector embedding machine learning semanticsIt's all semantics.www.bobdc.com 벡터 임베딩 정의- 벡터 임베딩은 단어와 문장 및 기타 데이터를 의미와 관계를 포착하는 숫자로 변환하는 방법입니다.- 텍스트, 이미..

LLM 2026.09.22

[쿠버네티스] 쿠버네티스의 구조

https://www.hanbit.co.kr/channel/view.html?cmscode=CMS5675948724&gad_source=1&gad_campaignid=23518945342&gbraid=0AAAAA_x2BewgWi5F5NZcIneowfewkbxH9&gclid=CjwKCAjwqonVBhA4EiwA9wYJ3Vq5fC5Be7fuBSnwJJH-eZXifvZGy6V7QwshVh25bb-0GXCcsRe3axoCX3MQAvD_BwE 원리부터 이해하는 쿠버네티스 - 클러스터, 컨트롤 플레인, 노드, 워크로드, 네트워크, 스토리지✅쿠버네티스의 개념 쿠버네티스는 어떻게 탄생했으며 어떤 역할을 수행하는지 알아봅시다. 1-1) 쿠버네티스의 어원과 역사쿠버네티스Kubernetes는 컨테이너화된 애플리케이션의 자동..

쿠버네티스 2026.09.12

[쿠버네티스] HPA(HorizontalPodAutoscaler)

https://kubernetes.io/ko/docs/tasks/run-application/horizontal-pod-autoscale-walkthrough/ HorizontalPodAutoscaler 연습HorizontalPodAutoscaler(약어: HPA)는 워크로드 리소스(예: 디플로이먼트 또는 스테이트풀셋)를 자동으로 업데이트하며, 워크로드의 크기를 수요에 맞게 자동으로 스케일링하는 것을 목표로 한다. 수평kubernetes.io HPAHorizontal scaling means that the response to increased load is to deploy more Pods. This is different from vertical scaling, which for Kuberne..

쿠버네티스 2026.09.10

[데이터 분석] 기초 통계 (분산, 표준편차)

분산과 표준편차 - 간단하게 계산할 수 있는 기초 통계량과 함께 데이터의 특징을 표현하는 지표로 분산(variance)과 표준편차(standard deviation)가 있습니다. - 평균으로부터 먼 곳까지 데이터가 퍼져 있다면 분산과 표준편차의 값이 커지며, 대부분의 데이터가 평균 근처에 위치한다면 분산과 표준편차의 값이 작아집니다. * 평균으로 부터 먼 곳에 분포 : 분산, 표준편차 값 상승 * 평균으로 부터 근처에 분포 : 분산, 표준편차 값 하락 표준오차 - 표준 오차에는 절대값을 활용해 계산하는 방법과 제곱을 통해 계산하는 방법이 있습니다. 1) 절대값을 활용한 표준오차 2) 제곱을 활용한 표준오차 * 절대값과 제곱을 이용한 표준오차 중 제곱을 사용하는 것이 데이터의 흐트러짐을 조금 더..

데이터분석 2026.08.21

[쿠버네티스] Deployment - 1

https://velog.io/@salgu1998/Kubernetes-%EC%BF%A0%EB%B2%84%EB%84%A4%ED%8B%B0%EC%8A%A4-Deployment Kubernetes 쿠버네티스 - Deployment(update, rollback)Deployment는 Pod 배포 자동화를 위한 오브젝트(ReplicaSet + 배포 전략)새로운 Pod를 Roll Out/Roll Back할 때 ReplicaSet 생성을 대신해줌다양한 배포 전략을 제공하고 이전 Pod에서 새로운 Pod로 전환 속도를 제velog.io Deployment란?쿠버네티스의 Deploymemt(디플로이먼트)는 Pod를 직접 관리하지 않고, ReplicaSet을 통해 Pod의 개수와 버전을 관리해 주는 상위 컨트롤러입니다...

쿠버네티스 2026.08.12